
它到底解决什么问题
很多网页自动化工具的问题,不是不会点按钮,而是页面一改、流程一变就要重写脚本。browser-use 走的是另一条路:你告诉 AI 要完成什么,它自己打开网页、观察页面、决定下一步,再执行点击、输入、滚动和提取内容。
它适合处理那些“有网页,但没 API”,或者流程经常变化的任务。比如查资料、整理后台数据、填写表单、做网站回归测试,也可以拿来做预约类流程:打开页面、查找可选时段、选择日期、提交结果。区别在于,这些步骤不是工程师提前写死的,而是 Agent 在执行过程中判断出来的。
browser-use 不是单纯的 Playwright 封装,也不是固定选择器工具。它把浏览器当成 AI 的“手和眼”,让模型能够读取页面状态,选择下一步操作,并根据结果继续调整。
目前它主要提供这些能力:
- 支持本地 Chrome、Chromium、远程 CDP 浏览器,也可以使用 Browser Use Cloud。
- 支持 OpenAI、Anthropic、Google Gemini、DeepSeek、Groq、Ollama 等十多种模型接入方式。
- 可以复用本机 Chrome 登录状态、Cookie 和扩展,也能导出 storage state 用于无头环境。
- 支持自定义工具、结构化输出、并行 Agent、MCP 服务以及现有的 Claude Code、Codex 等编码代理。
- 云端浏览器提供 profile、代理、实时预览、录制和部分验证码处理能力,但这些能力受目标网站和区域策略影响,不保证每个挑战都能自动通过。
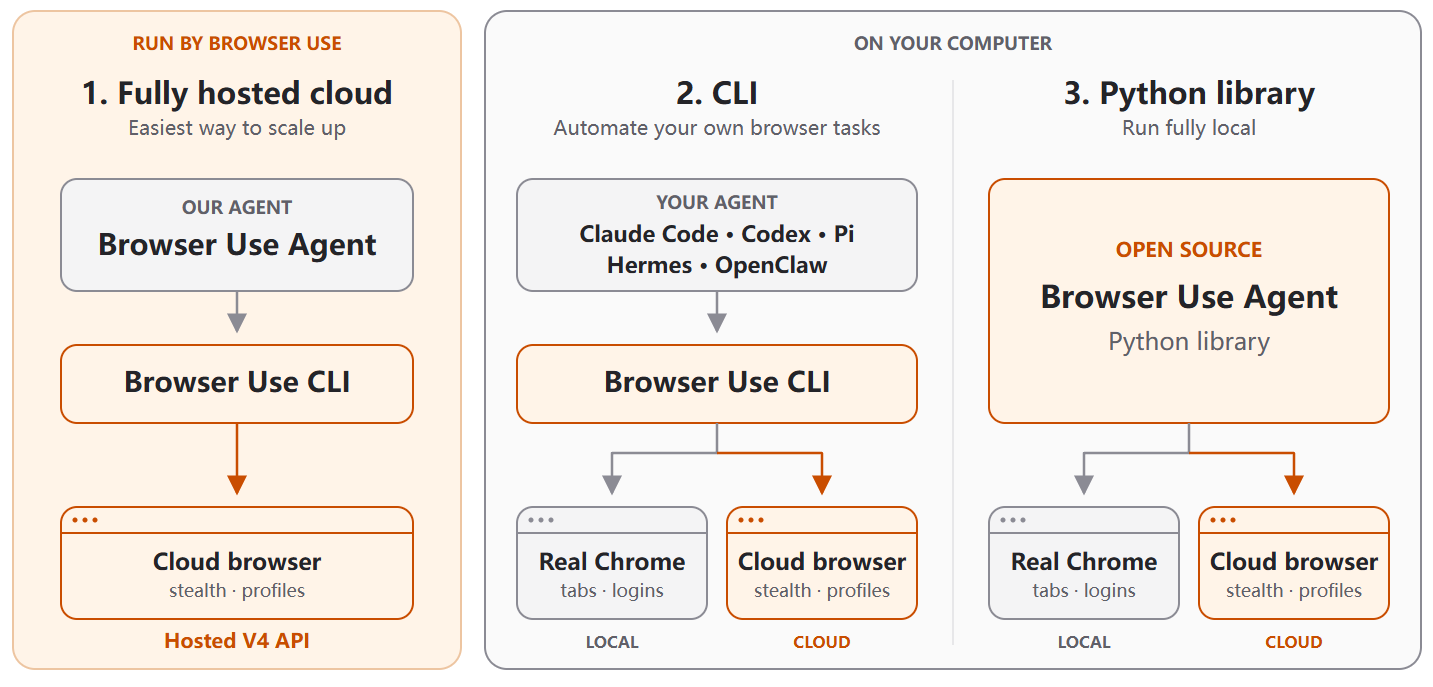
三条使用路线
第一种是完全托管的云端 Agent。你提交任务,Browser Use 负责 Agent、浏览器和运行环境,适合不想自己维护浏览器基础设施的人,但这是付费服务。
第二种是 CLI。它不替代你的 AI,而是给 Claude Code、Codex、Cursor 等现有工具加上浏览器操作能力。对于已经习惯让编码代理干活的用户,这条路线最顺手。
第三种是 Python 库。开源部分采用 MIT 协议,代码可以放在自己的机器或服务器上运行。模型调用费、云浏览器费用另算;如果使用本地 Ollama,也可以减少一部分 API 成本,但需要自己的硬件和合适的模型。
另外还有一个本地 MCP 模式,可以把 browser-use 的低层浏览器工具接进支持 MCP 的客户端。它适合已经有 MCP 工作流的用户,不过同样要自己管理 API Key、浏览器环境和安全边界。
安装和第一次运行
官方现在的 Python 版本要求是 Python 3.11 以上。用 uv 安装比较省事:
uv init --python 3.12
uv add browser-use
然后在项目目录里创建 .env 文件:
OPENAI_API_KEY=你的_API_Key
下面是一段最小可运行示例:
import asyncio

from browser_use import Agent, ChatOpenAI
from dotenv import load_dotenv

load_dotenv()

async def main():
    agent = Agent(
        task="打开 GitHub 的 browser-use 仓库,读取当前 Star 数,并输出数字和读取时间",
        llm=ChatOpenAI(model="gpt-5"),
    )

    history = await agent.run()
    print(history.final_result())

if __name__ == "__main__":
    asyncio.run(main())
运行:
uv run agent.py
如果任务需要登录,可以接入本机 Chrome:
from browser_use import Agent, Browser, ChatBrowserUse

browser = Browser.from_system_chrome()

agent = Agent(
    task="检查我的订单状态,并返回需要处理的订单编号",
    browser=browser,
    llm=ChatBrowserUse(),
)

await agent.run()
这种方式的好处是,本机 Chrome 已经登录过的网站,Agent 通常可以直接使用。但它也意味着 Agent 能看到你浏览器里的登录状态,所以不要随便把这种能力交给不可信的模型或第三方服务。Windows 上有时还需要先完全退出 Chrome,否则调试模式可能冲突。
如果只是把浏览器能力交给现有编码代理,可以安装 CLI:
uv tool install browser-use
browser-use --doctor
browser-use skill install
需要本地 MCP 服务时,可以运行:
uvx --from 'browser-use[cli]' browser-use --mcp
优点与坑点
它最明显的优点是省掉了大量脆弱的选择器维护。页面结构变了,Agent 通常还能根据页面内容重新判断怎么做。对于短期任务、内部工具、资料汇总和 QA 测试,这种“自然语言驱动浏览器”的方式确实比传统脚本灵活。
另一个优点是路线完整。你可以只使用开源 Python 库,也可以把它接到编码代理里,还可以把浏览器部分交给云端。模型选择也比较开放,不想绑定一家厂商时,这一点很重要。
但 browser-use 不适合被当成稳定、确定性的自动化流水线。LLM 的判断会受模型能力、页面结构、网络状态和提示词影响,同一个任务不一定每次都按完全一样的路径执行。关键任务至少要做结果校验,不能只看 Agent 最后说了一句“完成”。
验证码和风控也是现实问题。云端浏览器可以在部分场景降低验证挑战,或者处理受支持的验证码,但官方也没有承诺所有网站都能通过。更重要的是,使用前应该确认目标网站的服务条款和自动化规则。登录、支付、提交预约、删除数据这类动作,最好保留人工确认,不要让 Agent 无限制地自主执行。
成本方面也要提前算。开源代码本身免费,但模型 token、云浏览器、代理和并发都会产生费用。任务越长、截图越多、页面越复杂,消耗就越高。生产环境建议限制可访问域名,关闭不必要的视觉输入,把密码和验证码放进 sensitive_data,并对高风险操作加审批节点。
适合哪些人
如果你经常处理没有 API 的网页系统,browser-use 很值得试。它尤其适合内部效率工具、网页测试、信息采集、后台操作辅助,以及需要把浏览器能力交给 AI Agent 的开发场景。
如果你要的是完全可预测、毫秒级稳定执行、不会受模型波动影响的自动化,传统 Playwright 脚本仍然更合适。browser-use 的价值不是替代所有自动化代码,而是在页面复杂、流程变化快、规则难提前写清楚的时候,多给你一种更灵活的解决方式。
图片预览
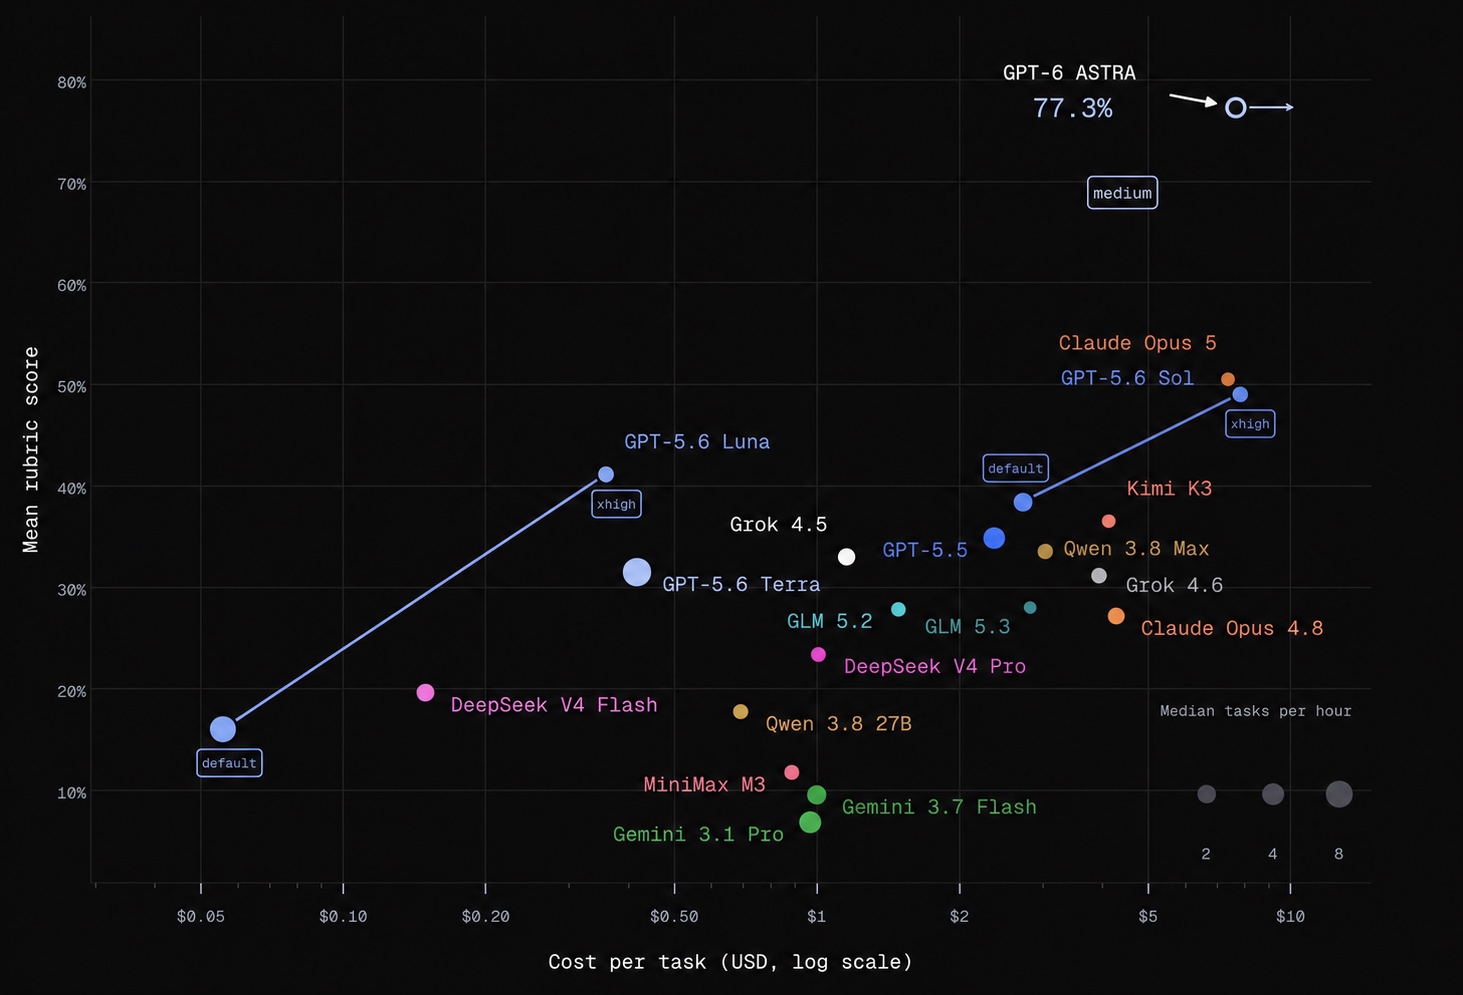
BU Bench V2自带的60个任务完成度结果
下载地址
https://github.com/browser-use/browser-use
https://pan.baidu.com/s/1lvbqM2HTq_Kwu2R_kinvyw?pwd=gnmy 提取码: gnmy
评论抢沙发